
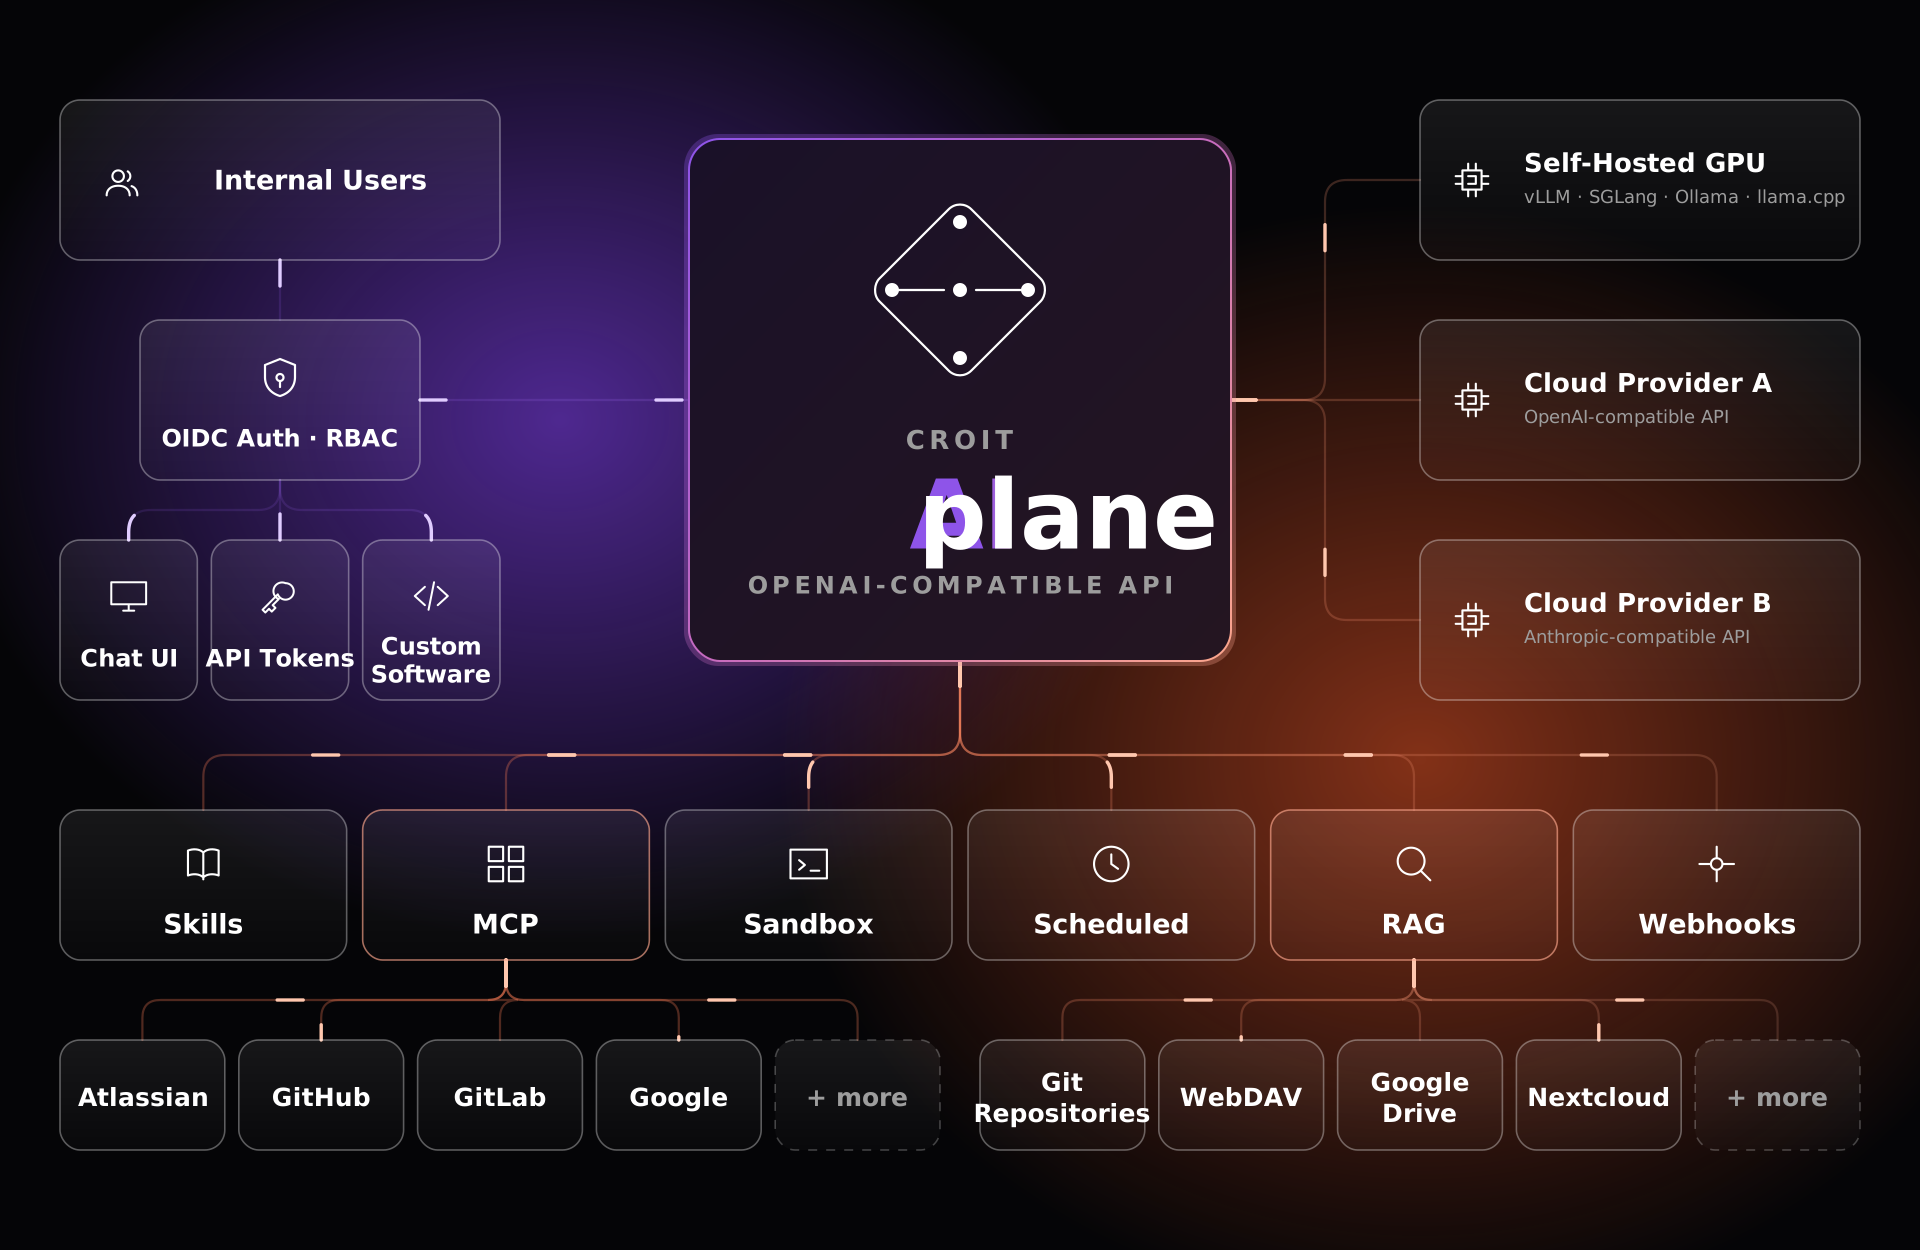
Infrastructure d'IA auto-hébergée · Compatible OpenAI · Open source
Un seul plan pour toute votre IA
croit aiplane est la couche d'infrastructure par laquelle passe l'IA de votre entreprise. Elle relie vos applications aux modèles, aux agents, aux outils et aux données de l'entreprise, et réunit l'identité, les règles et la consommation au même endroit.
N'importe quel modèle. N'importe quel outil. Votre infrastructure. Les clients compatibles OpenAI que vous utilisez déjà continuent de fonctionner, sans changement.
Un point de terminaison de modèle n'est pas une infrastructure d'IA
vLLM ou SGLang vous donne de l'inférence rapide. Il ne sait pas qui sont vos utilisateurs, quels modèles ils ont le droit d'atteindre, ce qu'ils ont dépensé le mois dernier, ni comment un modèle accède à votre wiki, à votre Jira et à votre code. aiplane est la couche qui tient tout cela : un endroit où se rejoignent modèles, agents, outils, données, identité et règles, posé sur l'inférence que vous exploitez déjà. Aucun framework d'agents à adopter, aucune application à réécrire. (aiplane est le produit publié auparavant sous le nom de croit LLM Gateway.)
Une couche, quatre choses qu'elle relie
Au-dessus : vos applications
Tout ce qui parle déjà l'API OpenAI ou Anthropic : SDK, services internes, assistants d'IDE et agents en ligne de commande, plus une interface de chat intégrée pour celles et ceux qui n'écrivent pas de code.
À travers : identité et règles
Chaque requête arrive par une connexion OIDC ou un jeton propre à l'utilisateur, et est confrontée aux modèles, aux outils et au budget auxquels cette personne a droit avant d'aller plus loin.
À l'intérieur : le runtime d'agents
aiplane exécute les outils côté serveur, à l'intérieur de la complétion : recherche web, RAG, connecteurs MCP, code en bac à sable, mémoire. Votre client reçoit toujours une réponse ordinaire.
En dessous : vos modèles
vLLM, SGLang, Ollama ou llama.cpp auto-hébergés à côté de fournisseurs hébergés. aiplane les sonde en continu, répartit entre les réplicas et encaisse une panne au lieu de faire échouer l'appelant.
Pourquoi les équipes placent AIplane devant leurs modèles
Rendre n'importe quel modèle agentique
Un modèle derrière vLLM répond à des prompts. Derrière aiplane, il cherche, lit vos documents, exécute du code et se souvient de ce qu'on lui a dit, pour chaque utilisateur et chaque client compatible OpenAI.
Une IA privée, sur votre propre matériel
L'inférence, les prompts, les documents et l'exécution des outils restent dans votre réseau. Dès qu'un point de terminaison approuvé existe, les services d'IA publics cessent d'être la solution de facilité.
Relier les modèles aux outils et aux données de l'entreprise
RAG sur git, Nextcloud et WebDAV, Google Drive et les archives de listes de diffusion. Connecteurs MCP vers GitHub, Jira, GitLab et Slack, chacun authentifié au nom de l'utilisateur.
Les modèles passent, votre aiplane reste
Un alias fait pointer un nom comme fast ou smart vers ce qui le sert à l'instant. Changez de modèle, ajoutez un réplica, passez sur du nouveau matériel : vos applications envoient toujours la même requête.
L'IA privée d'abord
L'auto-hébergement est ici le choix par défaut, pas une option de déploiement parmi d'autres. aiplane détecte ce qu'est réellement chaque backend, vLLM, SGLang, Ollama ou llama.cpp, et s'y adapte : il découvre la fenêtre de contexte, retrouve la façon dont ce serveur nomme l'effort de raisonnement, et contourne ce qu'il ne sait pas faire.
Le routage suit le comportement de l'inférence. Une stratégie tenant compte du cache KV garde une conversation sur le réplica qui détient déjà son préfixe ; least-inflight et round-robin pondéré sont là si vous les préférez. Des sondes de santé tournent toutes les quelques secondes, et quand tous les réplicas sont occupés ou hors service, les requêtes attendent et sont réessayées au lieu de renvoyer une erreur à l'appelant.
Comme les GPU sont les vôtres, leur usage peut être mesuré sans être facturé : marquez un pool auto-hébergé comme exempté et il ne comptera jamais contre le budget de qui que ce soit, tout en restant visible dans les tableaux de bord. Les modèles publics restent à une entrée de distance quand une tâche en a vraiment besoin.
L'agent tourne sur le plan, donc chaque client en a un
Quand le modèle appelle un outil, aiplane l'exécute et réinjecte le résultat dans la même complétion. L'application à l'origine de la requête reçoit une réponse ordinaire. Un script curl, un assistant d'IDE et l'interface de chat intégrée obtiennent donc le même agent, sans framework, sans code d'orchestration et sans boucle d'outils côté client à maintenir. Les outils restent éteints jusqu'à ce que le modèle demande le groupe dont il a besoin, ce qui garde la liste annoncée courte et les choix justes.
Plus de 50 outils intégrés, plus tout ce que vous branchez
Recherche et lecture web
Rechercher via SearXNG ou Brave, récupérer une URL, lire un PDF page par page
RAG sur vos données
Git, Nextcloud, WebDAV, Google Drive et listes de diffusion, par sens et par mot-clé à la fois
Connecteurs MCP
GitHub, Jira, GitLab, Slack et tout autre serveur MCP, authentifiés par utilisateur
Code en bac à sable
Outils Python, shell et données dans des conteneurs gVisor à usage unique, sans réseau par défaut
Documents
Rédiger et modifier sur un canevas versionné, exporter en PDF, DOCX ou PPTX
Mémoire
Ce qu'un utilisateur dit une fois est là à la conversation suivante, et reste le sien à modifier
Tourne tout seul
Prompts enregistrés déclenchés par une planification ou un webhook entrant, avec historique et rejeu
Images et parole
Générer et retoucher des images, transcrire de l'audio, parler au modèle, dès qu'un backend le sert
Fonctionne avec ce que vous exploitez déjà
Serveurs d'inférence
vLLM, SGLang, Ollama et llama.cpp sont détectés et profilés automatiquement. Tout ce qui parle le format OpenAI s'ajoute comme backend générique.
Clients compatibles OpenAI
Complétions de chat, embeddings, images, transcription et parole sur les chemins que vos SDK appellent déjà. Changez l'URL de base et la clé, rien d'autre.
Clients de l'API Anthropic
aiplane sert aussi l'API Anthropic Messages, pour que Claude Code et les outils du même genre tournent sur vos propres GPU, sous votre authentification, vos quotas et votre comptabilité d'usage.
Serveurs MCP
Branchez n'importe quel serveur MCP par URL. Huit connecteurs sont livrés dans le catalogue, dont GitHub, Jira et Confluence, GitLab, Slack et Google Workspace, avec OAuth géré par utilisateur.
Un contrôle qui tient à l'échelle de l'entreprise
Identité
OIDC avec PKCE contre Keycloak, Authentik, Entra, Okta ou tout fournisseur conforme
Rôles et groupes
Les groupes issus de vos claims OIDC filtrent modèles, outils, compétences, collections RAG et connecteurs
Jetons restreints
Jetons d'API par utilisateur, stockés seulement sous forme de hachage, limités à une partie des modèles et des outils
Quotas et budgets
Requêtes, jetons ou dépenses, par heure, jour, semaine ou mois, par utilisateur, rôle, jeton ou modèle
Un usage visible
Tableaux de bord en direct des requêtes, jetons, erreurs et coûts par utilisateur, modèle, backend et source
Les données restent chez vous
Conversations, documents et exécution d'outils vivent tous dans votre propre déploiement
Un binaire, un seul réglage obligatoire
aiplane est livré comme un binaire Rust unique, avec SQLite pour l'état, l'index vectoriel compilé dedans et l'interface web servie par le même processus sur le même port. Il n'y a pas de fichier de configuration à écrire : posez une clé de session, donnez-lui un volume, et terminez dans le navigateur, où l'assistant d'installation exige une vraie connexion avant de céder les droits d'administration. Exécutez-le sous systemd avec des Quadlets podman, avec Docker Compose, ou sur Kubernetes avec le chart Helm publié. L'exécution de code est la seule pièce hors du binaire, dans un service d'exécution durci distinct.
Du pilote à la production, avec croit à vos côtés
Commencer par un pilote qui est vraiment le vôtre
Nous montons aiplane face à vos modèles et à votre fournisseur d'identité, pour que vos équipes le jugent sur votre propre infrastructure plutôt que sur une diapositive.
Le brancher sur vos données et vos systèmes
Des collections RAG sur les dépôts et les espaces documentaires que vos équipes utilisent vraiment, des connecteurs MCP pour les outils de leur quotidien, des rôles et des quotas qui suivent l'organisation de votre entreprise.
L'exploiter comme de la production
Dimensionnement, durcissement et déploiement sous systemd, Docker ou Kubernetes, par une équipe qui exploite depuis des années des infrastructures d'entreprise et de HPC.
Garder quelqu'un responsable
Licence commerciale, support et lien direct avec les ingénieurs qui construisent aiplane, pour qu'une couche dont dépend votre entreprise ne soit le projet secondaire de personne.
Voyons ensemble à quoi ressemble votre aiplane
Dites-nous quels modèles vous exploitez aujourd'hui et ce que vous voulez permettre à vos équipes. Nous revenons vers vous avec une image concrète : l'installation, l'effort et ce qu'il en coûte de l'exploiter.
Les questions qui viennent en premier
Open source, porté par croit
Libre et open source
Publié sous AGPL-3.0, routage, runtime d'agents, outils, interface de chat et contrôle d'accès compris. Lisez le code avant de vous engager : pas de frais par siège, pas d'édition retenue, pas d'enfermement.
Porté par croit
Construit par l'équipe qui exploite des infrastructures à grande échelle dans des environnements d'entreprise et de HPC exigeants. Les personnes qui écrivent aiplane sont celles qui le déploient et le soutiennent pour vous.