Pour les équipes qui exploitent plus d'un cluster Ceph
Chaque cluster Ceph sur une seule carte
Pourquoi un cluster à la fois ne suffit plus
- 01
Aucune vue d'ensemble
Plusieurs clusters sur plusieurs sites, et aucun endroit qui dise si l'ensemble va bien. Les tableaux de bord de métriques montrent des KPI, pas les journaux, la configuration et la santé des disques dont un administrateur a besoin quand l'un d'eux ne va pas.
- 02
Fatigue des connexions
Avec vingt clusters, personne ne veut vingt interfaces ouvertes pour comparer un réglage ou suivre une alerte. L'onglet qui a le problème n'est jamais celui qui est devant.
- 03
Configuration inter-clusters à la main
Dans une interface mono-cluster, la réplication ne se configure qu'à moitié. Le reste, ce sont des commandes sur l'autre cluster pour que les deux s'apparient : lent, source d'erreurs, et différent à chaque fois.
- 04
Qui a changé quoi, et où
Deux clusters identiques dans deux régions devraient se comporter de la même façon. Comprendre pourquoi ce n'est pas le cas, et qui a changé quoi sur lequel, relève de la devinette sans vue côte à côte ni journal d'audit inter-clusters.
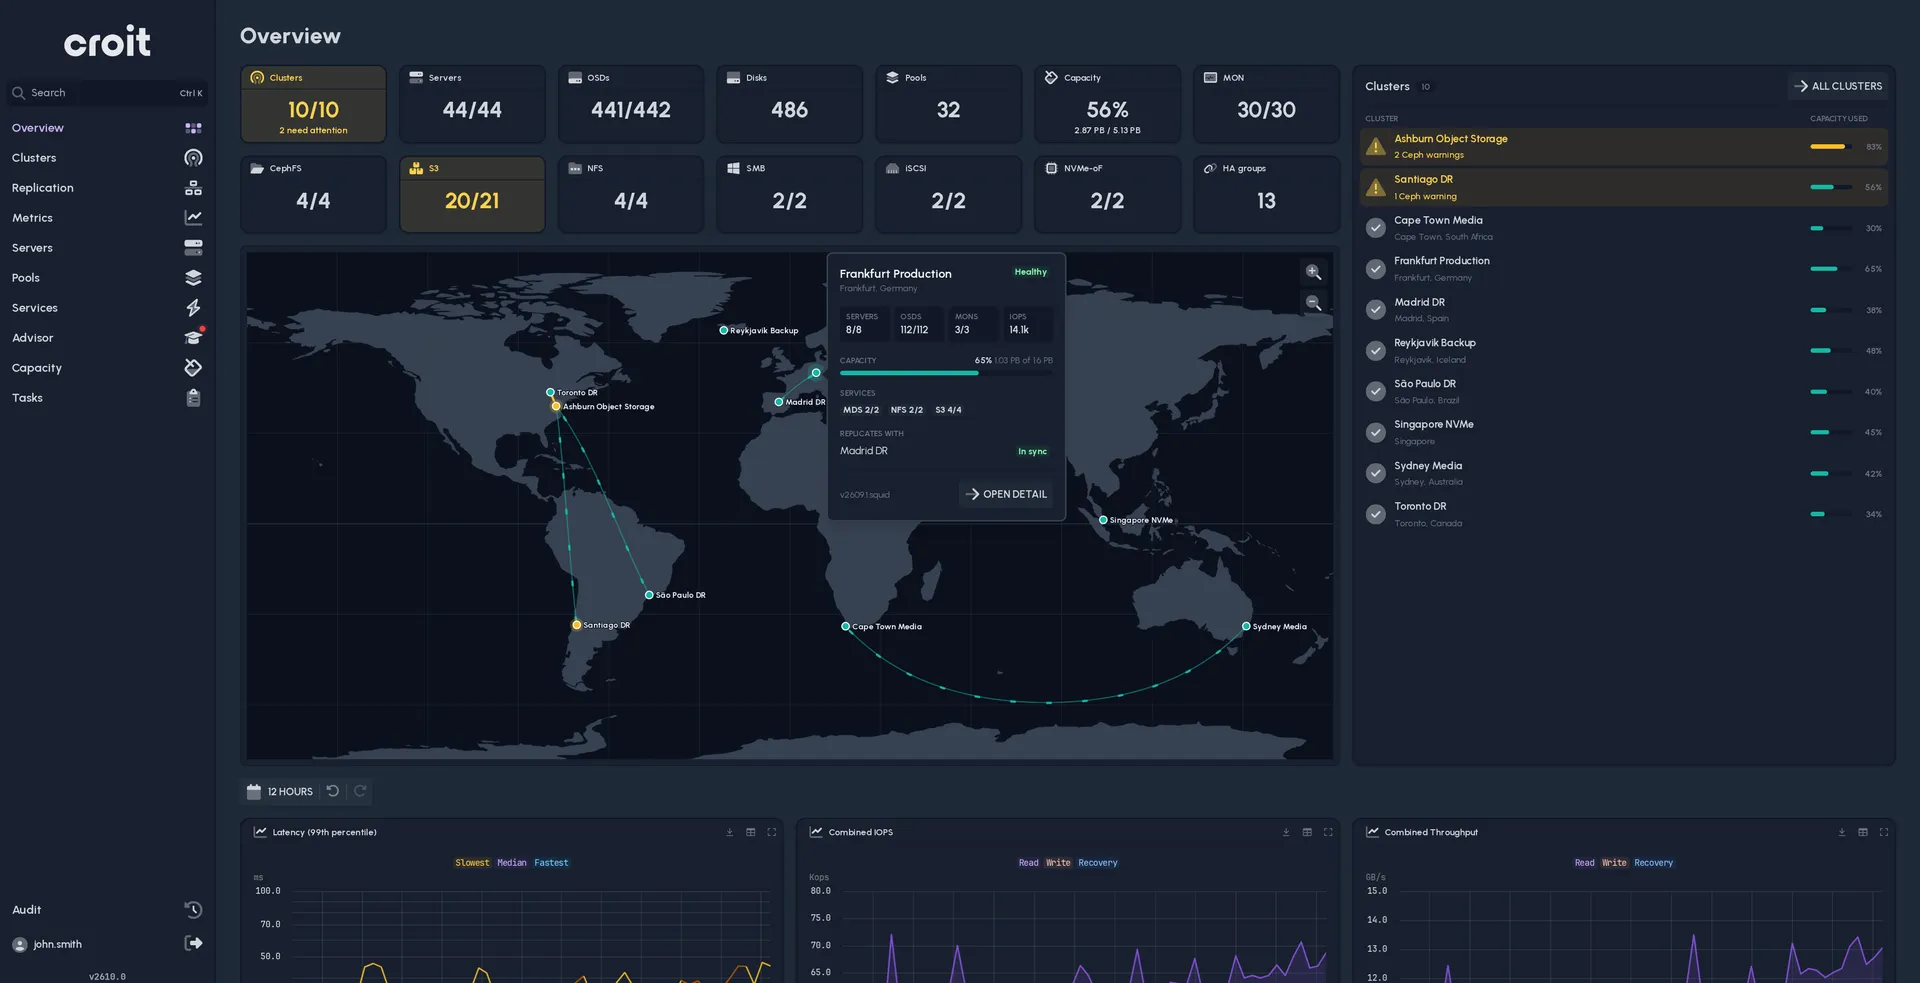
Tout voir
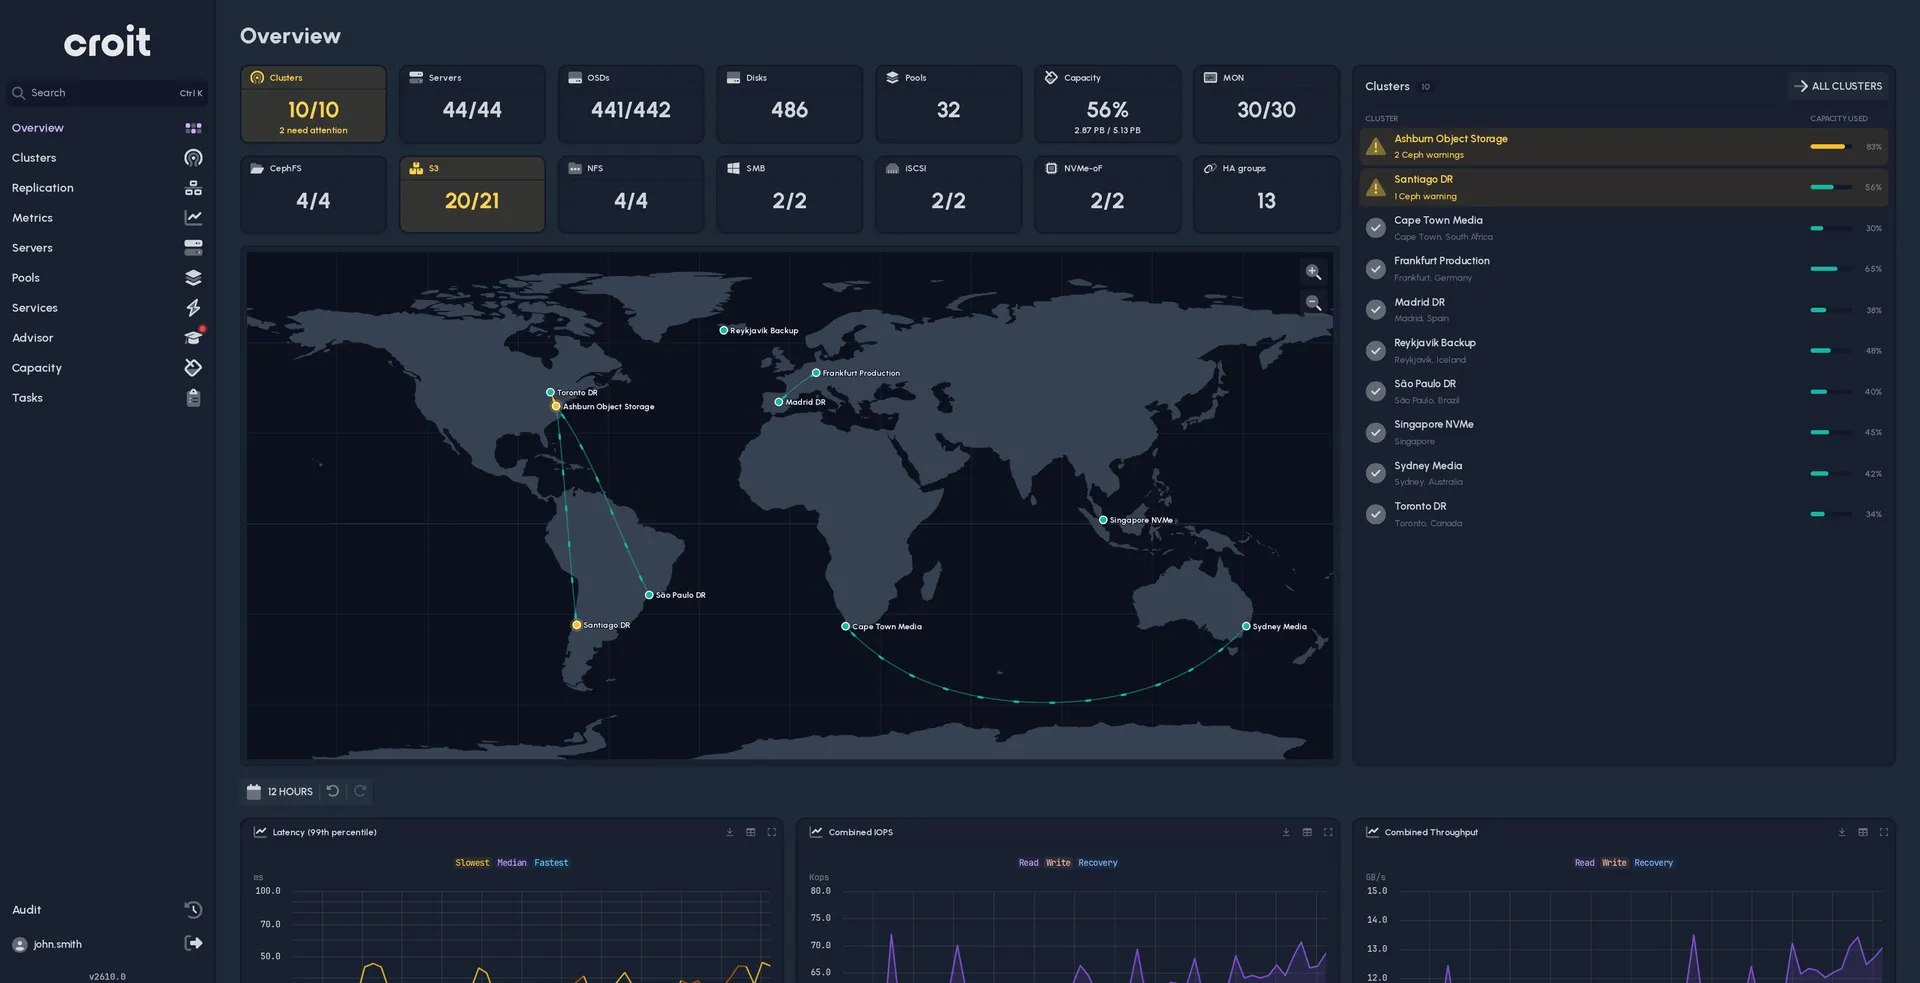
Une carte du monde avec l'état de chaque cluster, et en dessous les détails que les métriques laissent de côté : journaux, journalisation en direct, configuration, occupation des disques et santé SMART, ainsi que le journal d'audit.
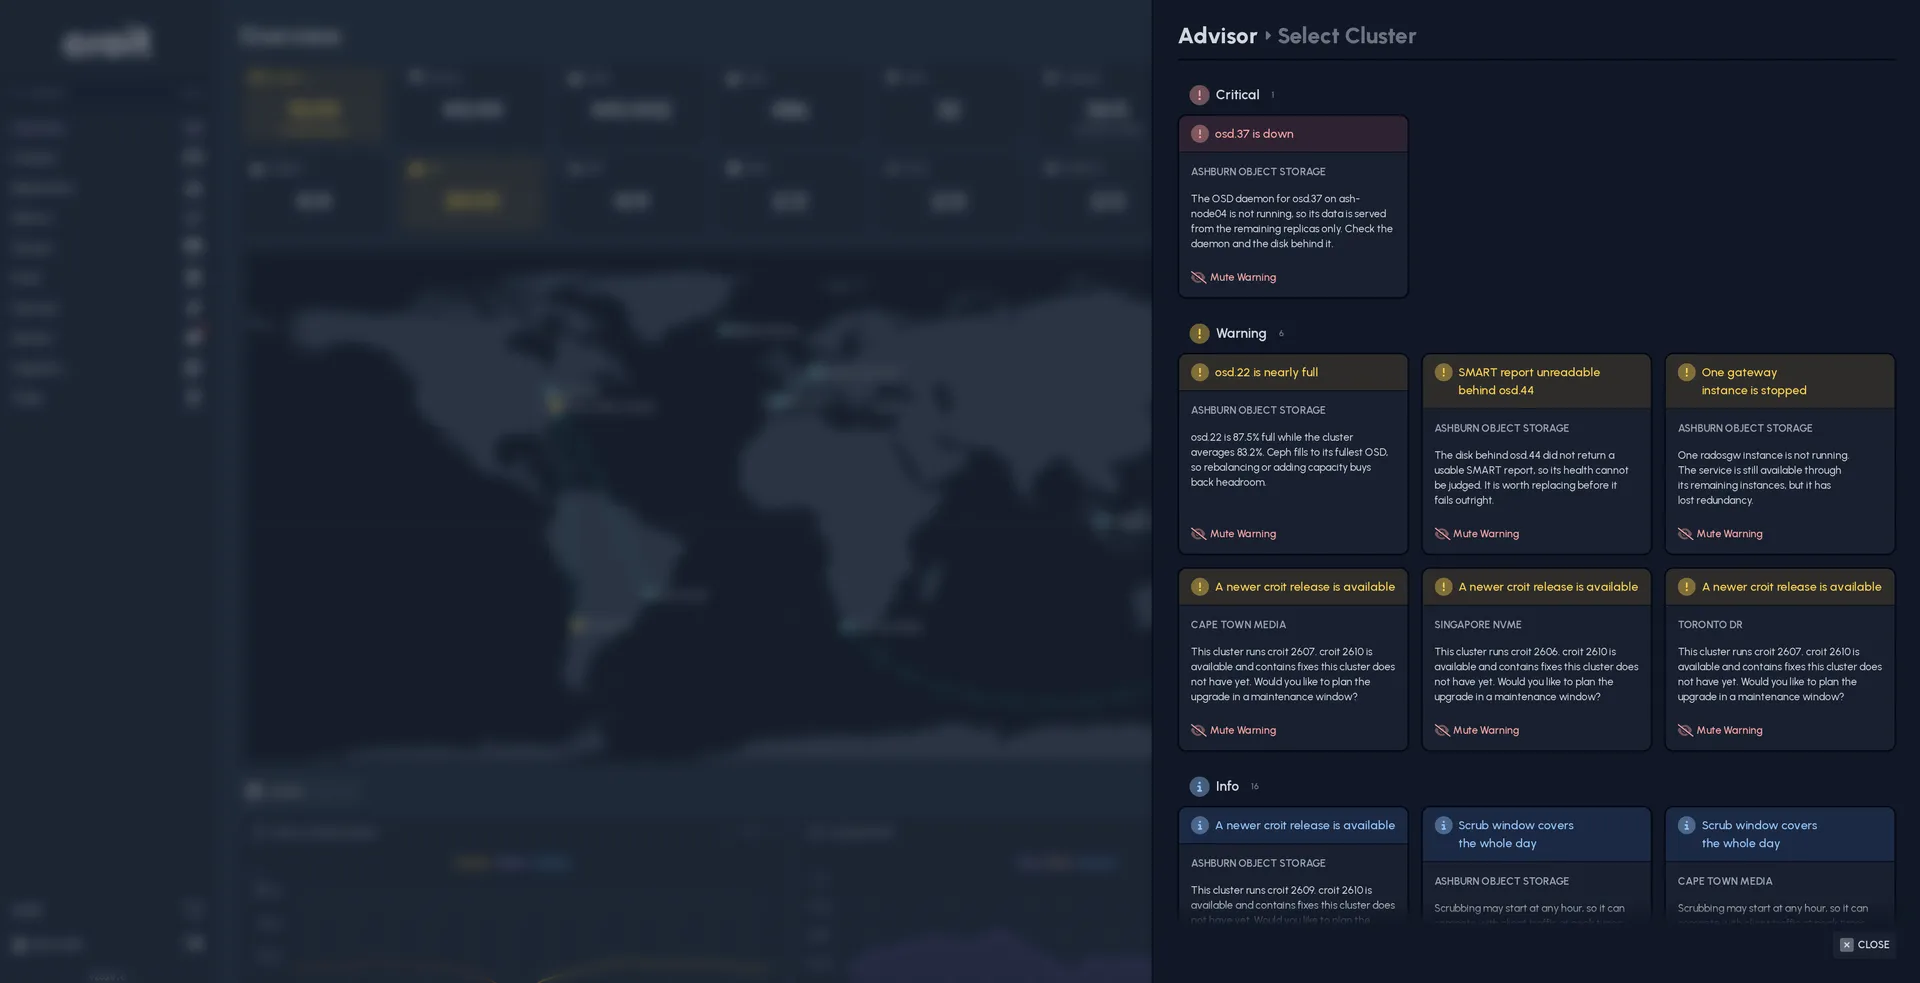
Agir de façon centralisée
Pas en lecture seule. Mises à jour et licences de chaque cluster depuis un seul endroit, changements de configuration, tickets de support ouverts là où le problème apparaît, et un clic pour entrer dans l'interface de n'importe quel cluster avec les mêmes identifiants.
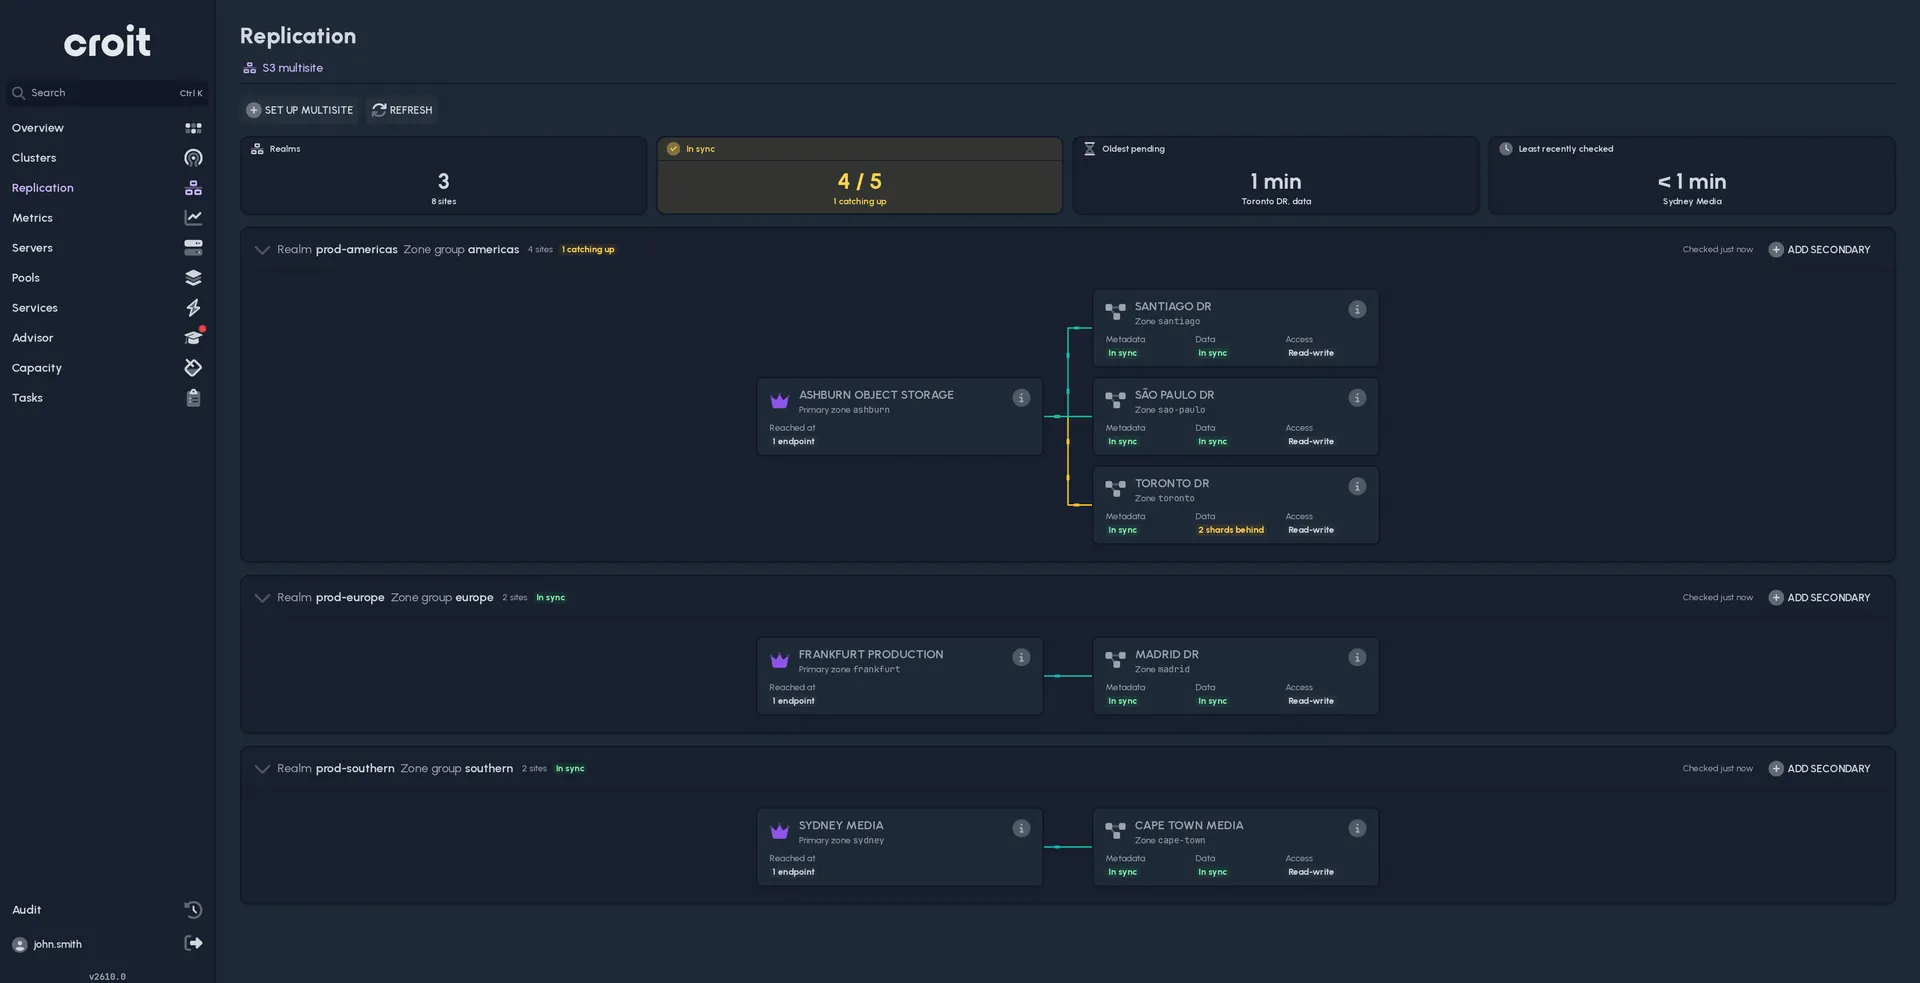
Relier les clusters
Des fonctions inter-clusters déployées de bout en bout : choisissez les clusters, choisissez le multisite S3, le mirroring CephFS ou le mirroring RBD, et le tableau de bord le déploie de chaque côté et affiche les flux de données entre les épingles.
Comment ça marche
- 1
Lancer un conteneur
Le tableau de bord est un conteneur Docker, lancé avec une seule commande et relié une fois à votre fournisseur d'identité OpenID Connect.
- 2
Ajouter un cluster
Saisissez l'adresse d'un manager croit ou d'un cluster Ceph natif, authentifiez-vous une fois et placez son épingle sur la carte. Autant que vous en exploitez, quand vous le souhaitez.
- 3
Entrer dans le détail
Cliquez sur une épingle pour les journaux, les disques et la configuration. Un bouton ouvre l'interface propre du cluster via un proxy avec vos identifiants, sans seconde connexion.
- 4
Relier les sites
Sélectionnez deux clusters ou plus et choisissez la réplication. Le tableau de bord configure les zones, groupes de zones et la synchronisation des buckets pour le multisite S3, ou met en place le mirroring CephFS et RBD, de chaque côté.
Deux régions, côte à côte
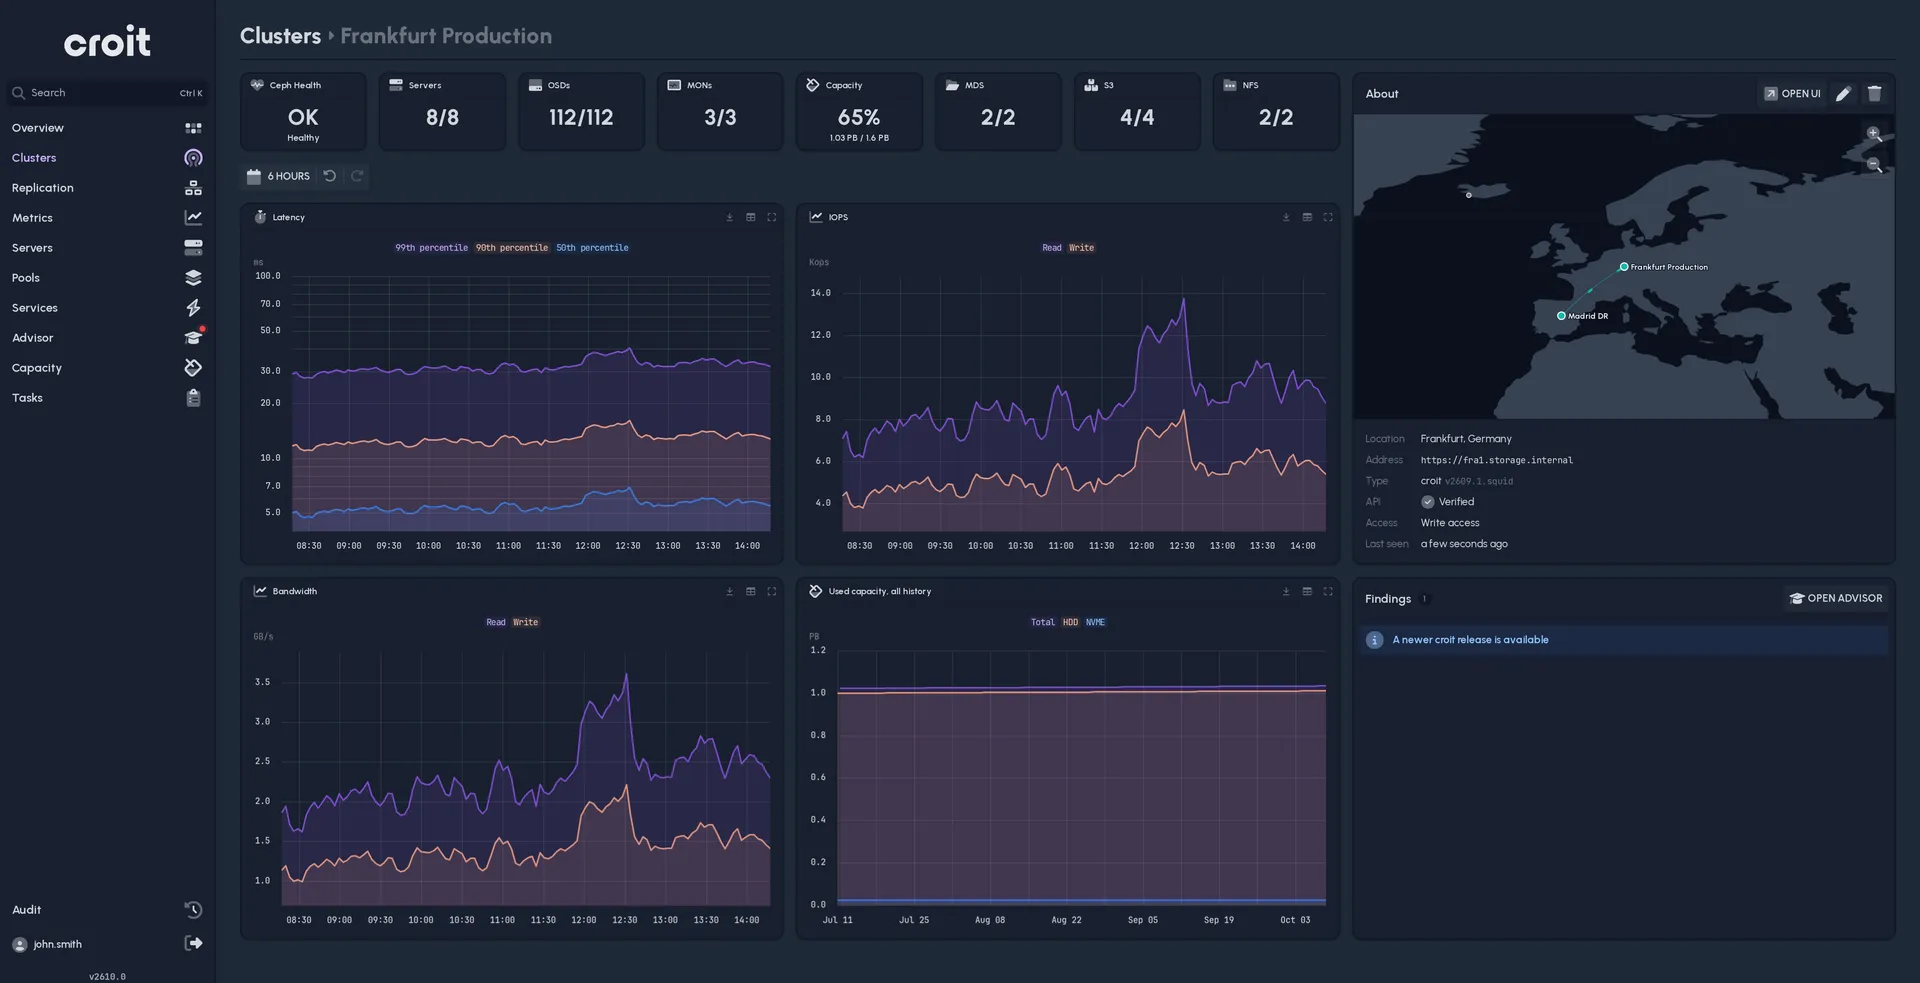
Frankfurt Production est en bonne santé : 8 serveurs sur 8, 65 % de remplissage, réplication vers Madrid, et une note de l'advisor signalant une nouvelle version.
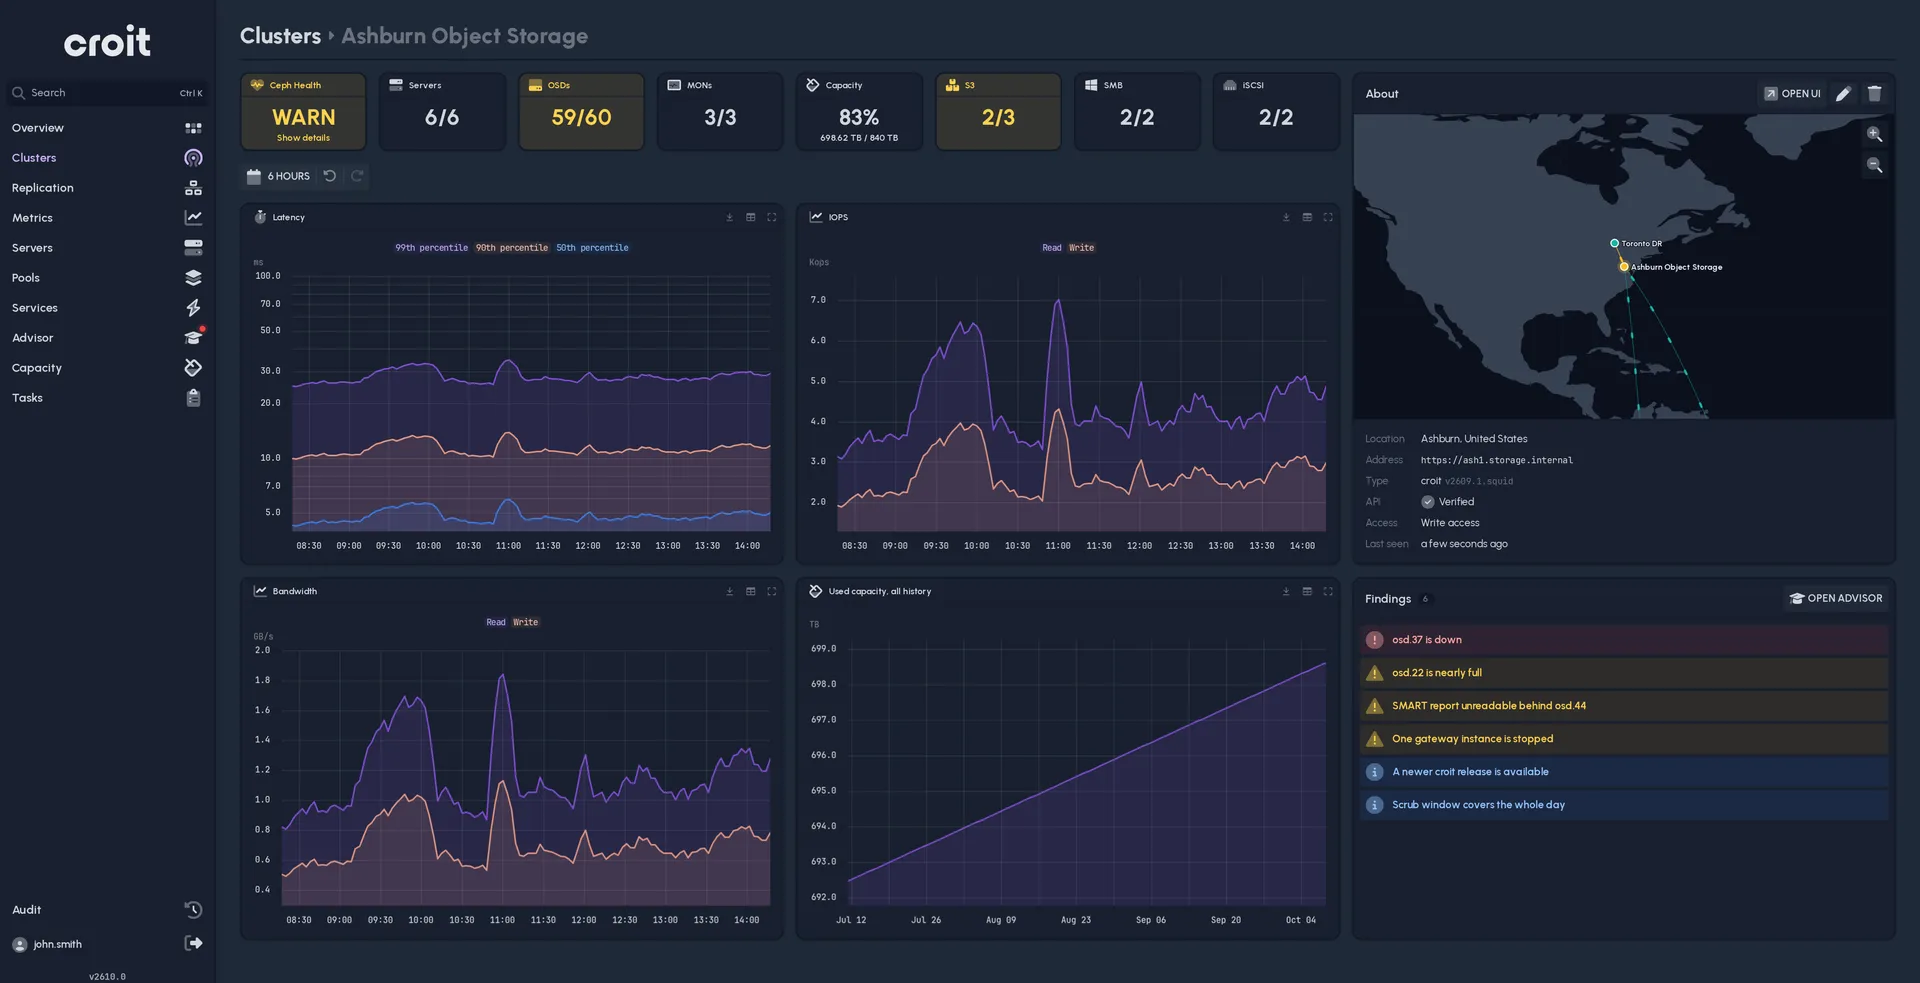
Ashburn Object Storage affiche un avertissement : un OSD en panne, 83 % de remplissage, une instance de passerelle arrêtée. Six constats, chacun avec la marche à suivre, avant que quiconque n'ouvre un ticket.
Ce qui fonctionne entre les clusters
Multisite S3
S3 géo-redondant
Zones, groupes de zones et synchronisation des buckets entre sites, pour la redondance ou une diffusion de type CDN près des utilisateurs. Configuré visuellement, avec les flux de données affichés sur la carte.
Mirroring CephFS
Des systèmes de fichiers répliqués sur le WAN
L'implémentation parallèle propre à croit du mirroring CephFS, conçue pour la réplication entre sites. Configurée de façon centralisée pour les clusters que vous choisissez.
Mirroring RBD
Des périphériques bloc dans deux clusters
Reprise après sinistre pour les machines virtuelles et les bases de données : des images RBD mises en miroir vers un second site, configurées depuis le tableau de bord plutôt que sur chaque cluster.
Journal d'audit
Qui a fait quoi, sur quel cluster
Sur les clusters croit, chaque clic et chaque appel d'API est enregistré. Le tableau de bord montre la trace de tout votre parc en un seul endroit, pour le jour où quelqu'un pose la question.
Capacité sur tout le parc
Savoir quel cluster se remplira en premier
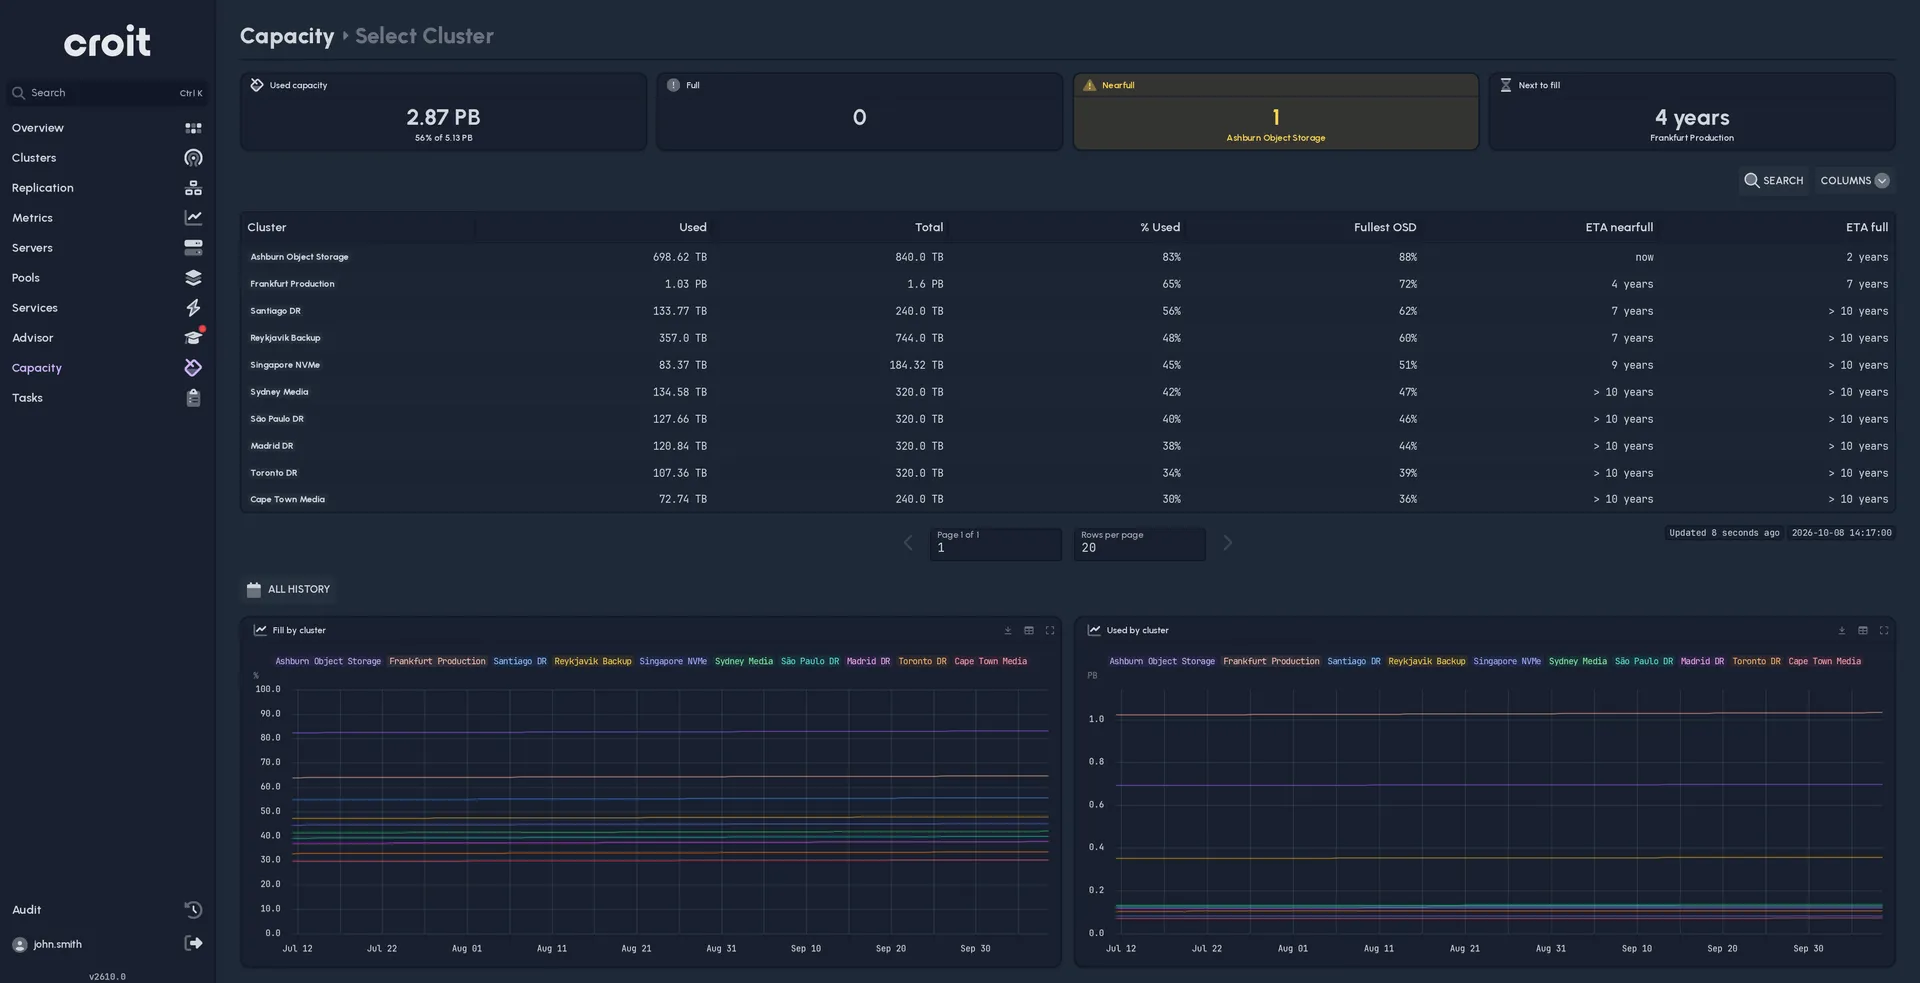
Capacité utilisée et totale de chaque cluster dans un seul tableau, l'OSD le plus plein de chacun, et une estimation du moment où il atteindra nearfull puis plein. Ashburn demande une attention immédiate, Francfort a quatre ans devant lui. Budgétez les prochains serveurs avant que l'astreinte ne le fasse.
Clusters croit et Ceph natif
Le tableau de bord gère les clusters croit et les clusters Ceph natifs de la même manière. Ce qu'il peut faire sur chacun dépend du type et de la version du cluster : les clusters croit apportent le journal d'audit, les mises à jour centralisées et la vue détaillée complète ; un cluster Ceph natif obtient la carte, l'accès aux détails et les fonctions inter-clusters qu'il prend en charge. Faire entrer un cluster Ceph existant dans le tableau est souvent le premier pas vers son exploitation avec croit.
Voyez vos clusters sur une seule carte
Dites-nous combien de clusters vous exploitez et où, et nous vous montrons le tableau de bord sur une configuration comme la vôtre, avec un devis pour votre nombre de clusters.
FAQ
Oui. Les clusters Ceph natifs s'ajoutent comme les clusters croit : saisir l'adresse, s'authentifier une fois, placer l'épingle. L'étendue des fonctions dépend du type et de la version du cluster ; les clusters croit ajoutent le journal d'audit et la gestion centralisée des mises à jour et des licences.
Non. C'est un conteneur Docker que vous exécutez où vous voulez, lancé avec une seule commande et relié à votre propre fournisseur d'identité OpenID Connect. Rien sur vos clusters ne quitte votre environnement.
Non. Il se place au-dessus. Pour tout ce qui est propre à un cluster, un bouton ouvre l'interface de ce cluster via un proxy avec les mêmes identifiants, sans seconde connexion.
Grafana et Prometheus montrent des métriques. Le tableau de bord montre ce dont vous avez besoin dès qu'une métrique semble anormale : journaux, journalisation en direct, configuration, occupation des disques et santé SMART, et il vous laisse agir : mises à jour, licences, tickets et changements de configuration depuis un seul endroit. Gardez Grafana pour les KPI ; le tableau de bord est là pour l'étape suivante.
Dès le deuxième cluster. Avec un seul cluster, son interface suffit. Avec deux sites, vous avez déjà une réplication à configurer et deux connexions à jongler, et le tableau de bord gagne sa place au premier incident qui touche les deux.
Demandez-nous. Le prix dépend du nombre de clusters raccordés ; dites-nous combien vous en exploitez et où, et vous recevez un devis avec la démo.